AI 학습은 막고 검색 노출은 지킨다 — 9월 15일 바뀐 크롤러 기본값 점검

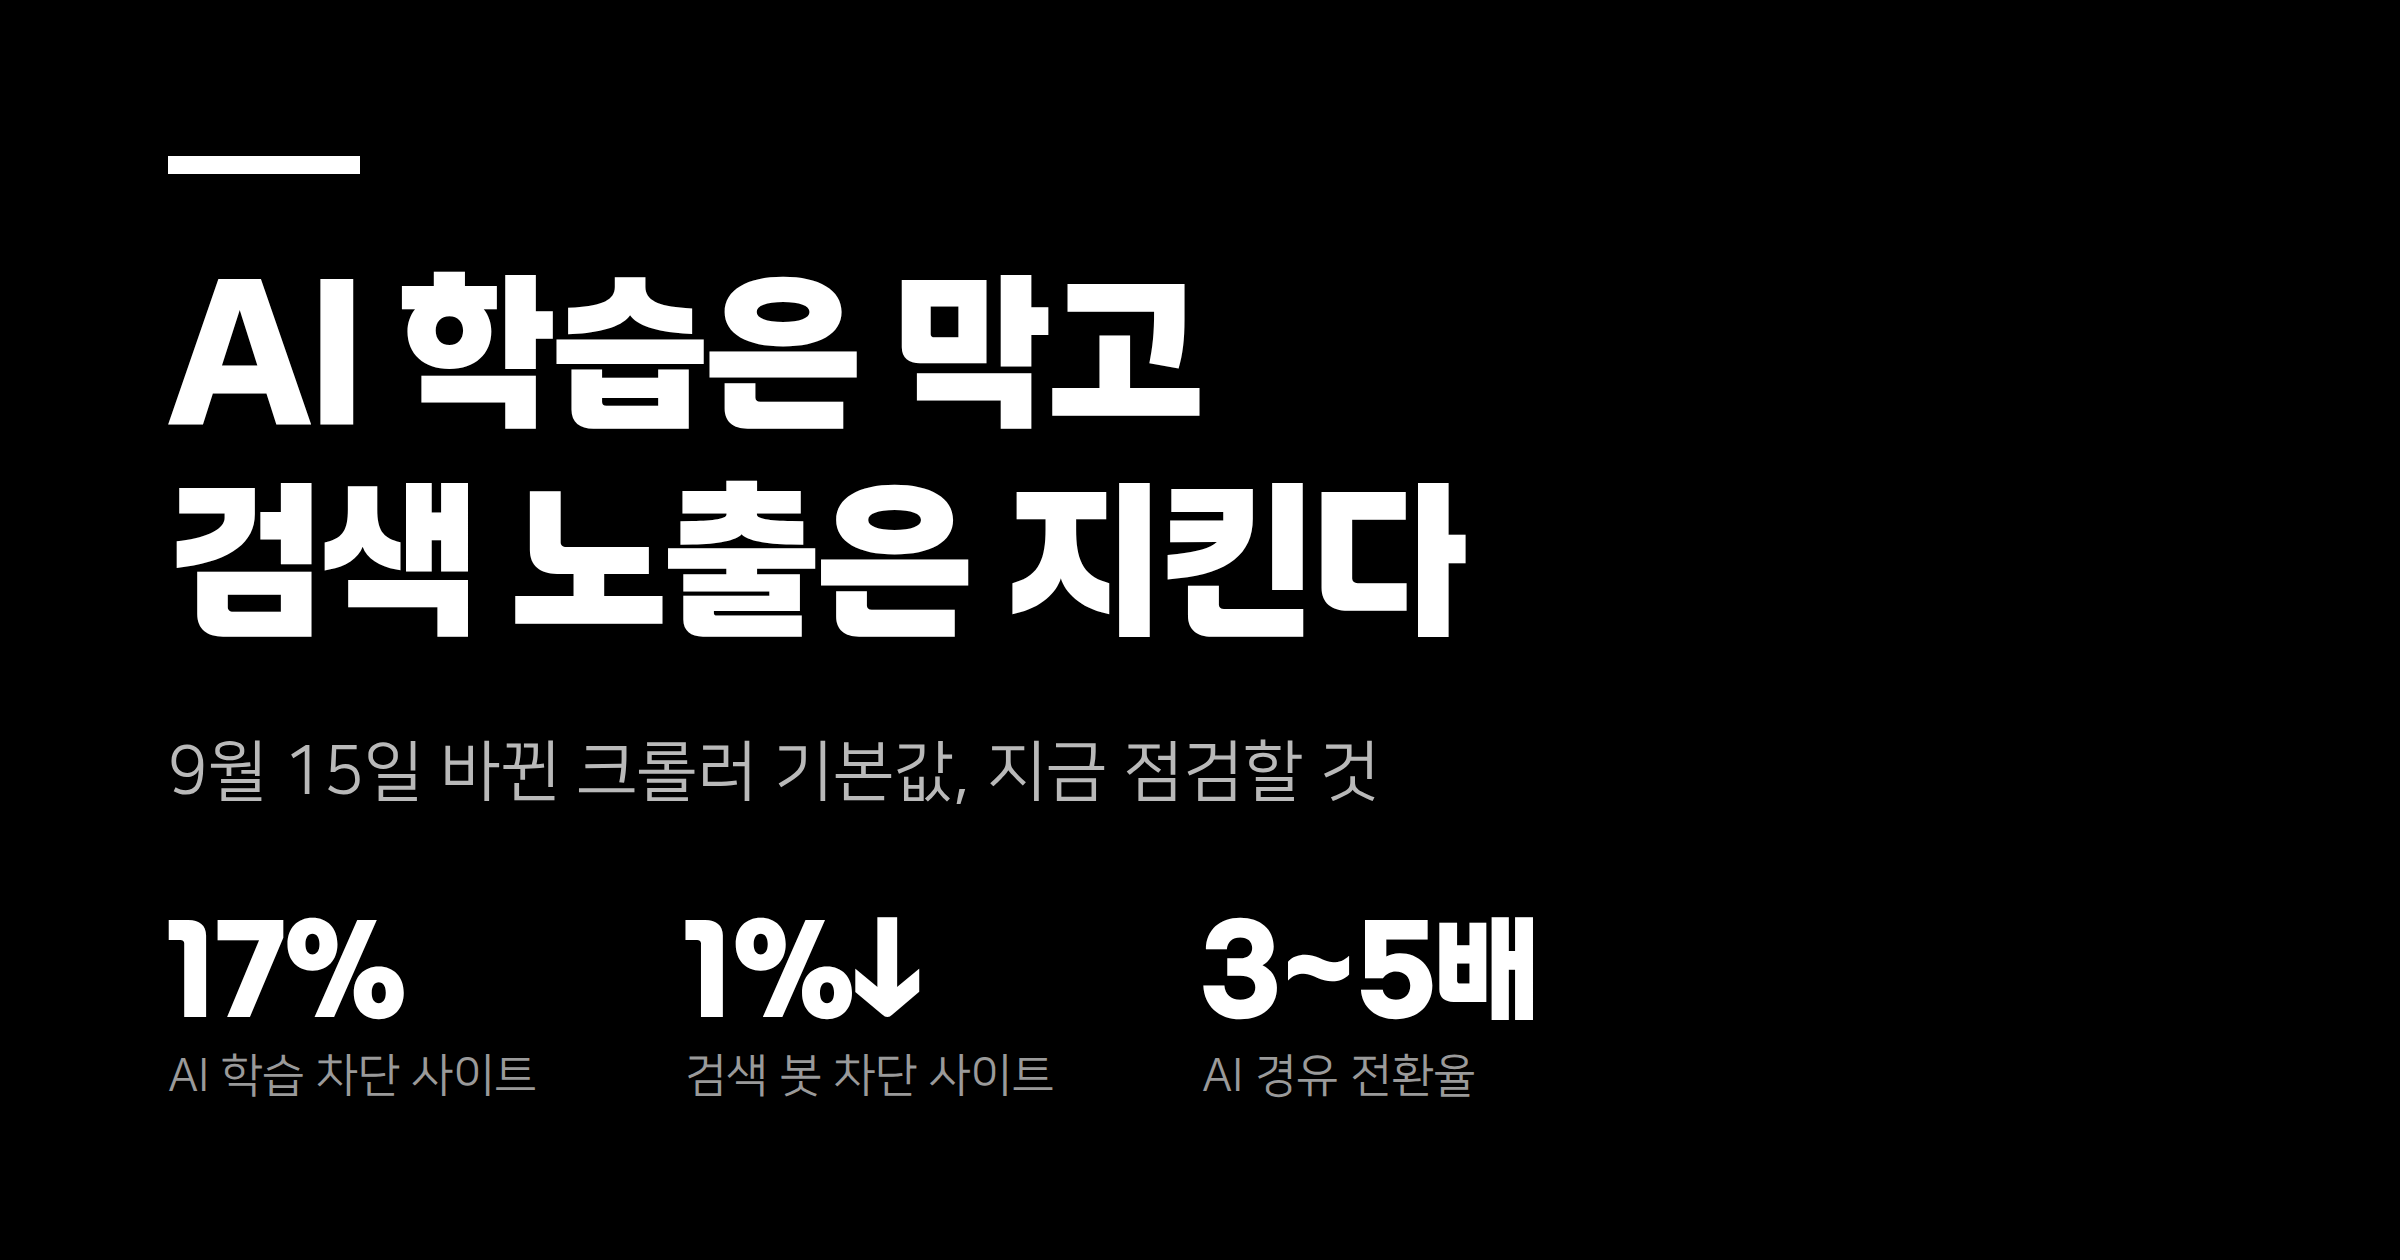
홈페이지의 크롤러 접근 설정이 이제 마케팅 성과 지표를 직접 흔드는 변수가 됐습니다. 2026년 9월 15일부터 클라우드플레어가 AI 크롤러 제어 옵션을 네 단계로 나눠 제공하기 시작했고, 신규로 만들어지는 도메인에는 기본값이 미리 지정됩니다. 광고를 싣는 사이트는 'AI 학습 비허용'이 기본으로 들어가고, 에이전트 성격의 크롤러는 광고가 붙은 페이지에서 차단되는 쪽으로 세팅됩니다. 광고가 없는 사이트는 전부 허용이 기본입니다.
여기서 실무자가 짚어야 할 지점은 설정 이름이 아니라 구조입니다. 예전에는 '검색엔진에 잘 걸리게 해달라'는 요청이 콘텐츠와 태그 이야기였습니다. 지금은 방화벽과 CDN 설정 화면에서 체크박스 하나가 검색 유입과 AI 답변 인용을 동시에 끊을 수 있습니다. 그리고 이 차단은 robots.txt 파일만 들여다봐서는 보이지 않습니다. 네트워크 단에서 걸리기 때문에, 서버 로그나 서치콘솔의 크롤링 통계를 봐야 드러납니다.
<무엇이 어떻게 바뀌었나>
원래 클라우드플레어가 7월 1일에 예고한 방식은 더 거칠었습니다. AI 학습을 거부하겠다고 선택하면 검색과 학습을 겸하는 크롤러, 즉 구글봇·애플봇·빙봇까지 함께 막히는 구조였습니다. 크롤러 하나가 여러 목적을 갖고 있으니 가장 엄격한 규칙을 적용한다는 논리였는데, 이게 현장에서는 문제가 됩니다. 클라우드플레어가 밝힌 수치로 AI 학습 차단 장치를 켜둔 사이트는 17%인데, 검색 봇까지 막겠다는 사이트는 1%가 안 됩니다. 원하는 것과 실제로 벌어지는 일이 어긋나는 겁니다.
9월 15일에 실제로 나온 건 그 사이를 갈라놓는 옵션입니다. 정리하면 네 가지입니다.
허용 — 다른 규칙에서 막지 않는 한 모든 크롤러가 들어옵니다.
AI 학습 비허용 — robots.txt에 학습을 원하지 않는다는 표시를 쓰면서, 검색 목적의 접근은 유지합니다. 학습만 하는 크롤러는 막습니다.
광고 노출 페이지에서 차단 — 광고가 실리는 페이지에만 차단을 적용합니다.
전체 차단 — 검색 크롤러까지 포함해 다 막습니다. 이건 이제 부작용이 아니라 명시적인 선택입니다.
기존에 유료로 쓰고 있던 설정은 그대로 이어집니다. 문제는 새로 만든 도메인, 새로 붙인 서브도메인, 그리고 무료 등급에서 운영하던 사이트입니다. 손대지 않았는데 기본값이 들어가 있을 수 있습니다.
<'책임 있는 크롤러'라는 개념이 생겼다>
이번 변경에서 실무적으로 더 중요한 건 옵션 개수가 아니라, 검색용 접근을 유지해줄 크롤러를 가리는 기준이 생겼다는 점입니다. 클라우드플레어가 내건 조건은 네 가지입니다. robots.txt나 그에 준하는 방법으로 AI 학습을 거부할 수 있어야 하고, AI 요약에서 빠지는 것도 선택할 수 있어야 하고, 학습 데이터와 검색 지표를 URL 단위로 볼 수 있어야 하며, 학습을 거부해도 검색 순위에 영향이 없다는 점을 확인해줘야 합니다.
현재 상태를 보면 구글은 Google-Extended 지시문을 지키고 웹마스터 도구에서 요약 노출을 끌 수 있으며 학습 거부가 검색 순위에 영향을 주지 않는다고 확인했습니다. 애플은 Applebot-Extended로 거부를 받고 nosnippet 지시문을 씁니다. 마이크로소프트는 아직 NOARCHIVE 메타태그 방식이고, robots.txt 기반 지원은 2027년 초를 목표로 준비 중이라고 밝혔습니다.
세 회사가 서로 다른 방법을 쓰고 있다는 게 핵심입니다. 한 군데 설정을 맞춰놓고 다 됐다고 보면 안 됩니다.
<왜 지금 이 설정을 건드려야 하나>
숫자를 보면 이유가 분명합니다. 검색 결과에서 AI 요약을 읽는 이용자는 절반을 넘었습니다. 그리고 AI를 경유해 들어온 방문자의 전환율은 기존 검색 유입 대비 3~5배로 집계됩니다. 유입량으로만 보면 아직 작지만 단위당 가치는 훨씬 높은 구간입니다.
반대로 학습용 수집은 당장의 매출과 직접 연결되지 않습니다. 콘텐츠를 쌓아놓은 쪽에서는 학습에는 쓰이고 트래픽은 돌아오지 않는 상황을 받아들이기 어렵습니다. 그래서 '학습은 거부하고 검색과 인용은 유지한다'는 선택이 실제 필요했던 것이고, 이번에 그 선택이 도구 형태로 나왔습니다.
다만 주의할 점이 있습니다. 거부 표시를 해도 지키지 않는 수집기가 있습니다. 관련 조사에서 AI 크롤러의 15%가 접근 거부가 걸린 URL에 그대로 접근한 사례가 확인됐습니다. 표시는 의사 표현이고 차단은 별개 작업이라는 뜻입니다.
<점검 순서>
순서를 정해두고 한 번에 보는 편이 낫습니다.
첫째, 지금 설정이 무엇인지 확인합니다. 우리가 고른 값이 아니라 기본값이 들어가 있는 경우를 찾는 게 목적입니다. 특히 최근 1년 안에 새로 만든 도메인, 랜딩 전용 서브도메인, 캠페인용으로 급하게 띄운 페이지를 먼저 봅니다. 마케팅팀이 모르는 사이에 개발팀이나 외부 업체가 만든 도메인이 여기 걸립니다.
둘째, 서치콘솔에서 크롤링 통계와 색인 상태를 봅니다. 9월 중순 이후 크롤링 요청 수가 꺾였거나 응답 코드에 403이 늘었다면 네트워크 단 차단을 의심할 수 있습니다. robots.txt 테스트만으로는 안 잡힙니다.
셋째, 서버 로그에서 크롤러별 접근을 나눠 봅니다. 구글봇과 학습용 크롤러가 섞여 있으니 사용자 에이전트 단위로 분리해야 판단이 됩니다. 로그를 못 보는 환경이면 최소한 CDN 쪽 차단 이벤트 기록이라도 받아둡니다.
넷째, 정책을 결정합니다. 콘텐츠가 자산인 사이트라면 학습 비허용에 검색 유지가 기본선입니다. 반대로 AI 답변에 인용되는 것 자체가 목표인 브랜드 사이트라면 허용 쪽이 맞습니다. 사이트 하나에 한 가지 답만 있는 게 아니라, 자료실과 블로그는 다르게 가도 됩니다.
다섯째, 결정 사항을 문서로 남깁니다. 이 설정은 마케팅이 아니라 인프라 담당자가 만지는 화면에 있습니다. 누가 왜 이렇게 두었는지 적어두지 않으면 반년 뒤에 아무도 모릅니다.
<조직 차원에서 남는 과제>
이번 변경이 가리키는 건 기술 이슈 하나가 아닙니다. 검색 노출을 결정하는 손잡이가 콘텐츠팀 밖으로 나갔다는 사실입니다. 태그 관리, 리다이렉트, 봇 정책 같은 항목이 전부 이쪽에 해당합니다.
지아이오엠이 사이트 개편이나 이전 건을 볼 때 광고 태그와 함께 크롤러 접근 정책을 같은 체크리스트에 넣는 이유가 여기 있습니다. 광고비를 아무리 잘 써도 색인이 빠지면 회복에 몇 주가 걸립니다. 반면 점검은 반나절이면 끝납니다. 비용 대비로 따질 것도 없는 작업입니다.
분기 시작에 맞춰 도메인 목록을 한 번 정리해두시길 권합니다. 운영 중인 도메인과 서브도메인, 각각의 CDN 설정 주체, 현재 크롤러 정책. 이 세 열만 채워도 사고 대부분은 미리 걸립니다.
함께 그려볼까요?