AI가 우리 브랜드를 검색할 때 결국 보는 곳은 우리 사이트입니다

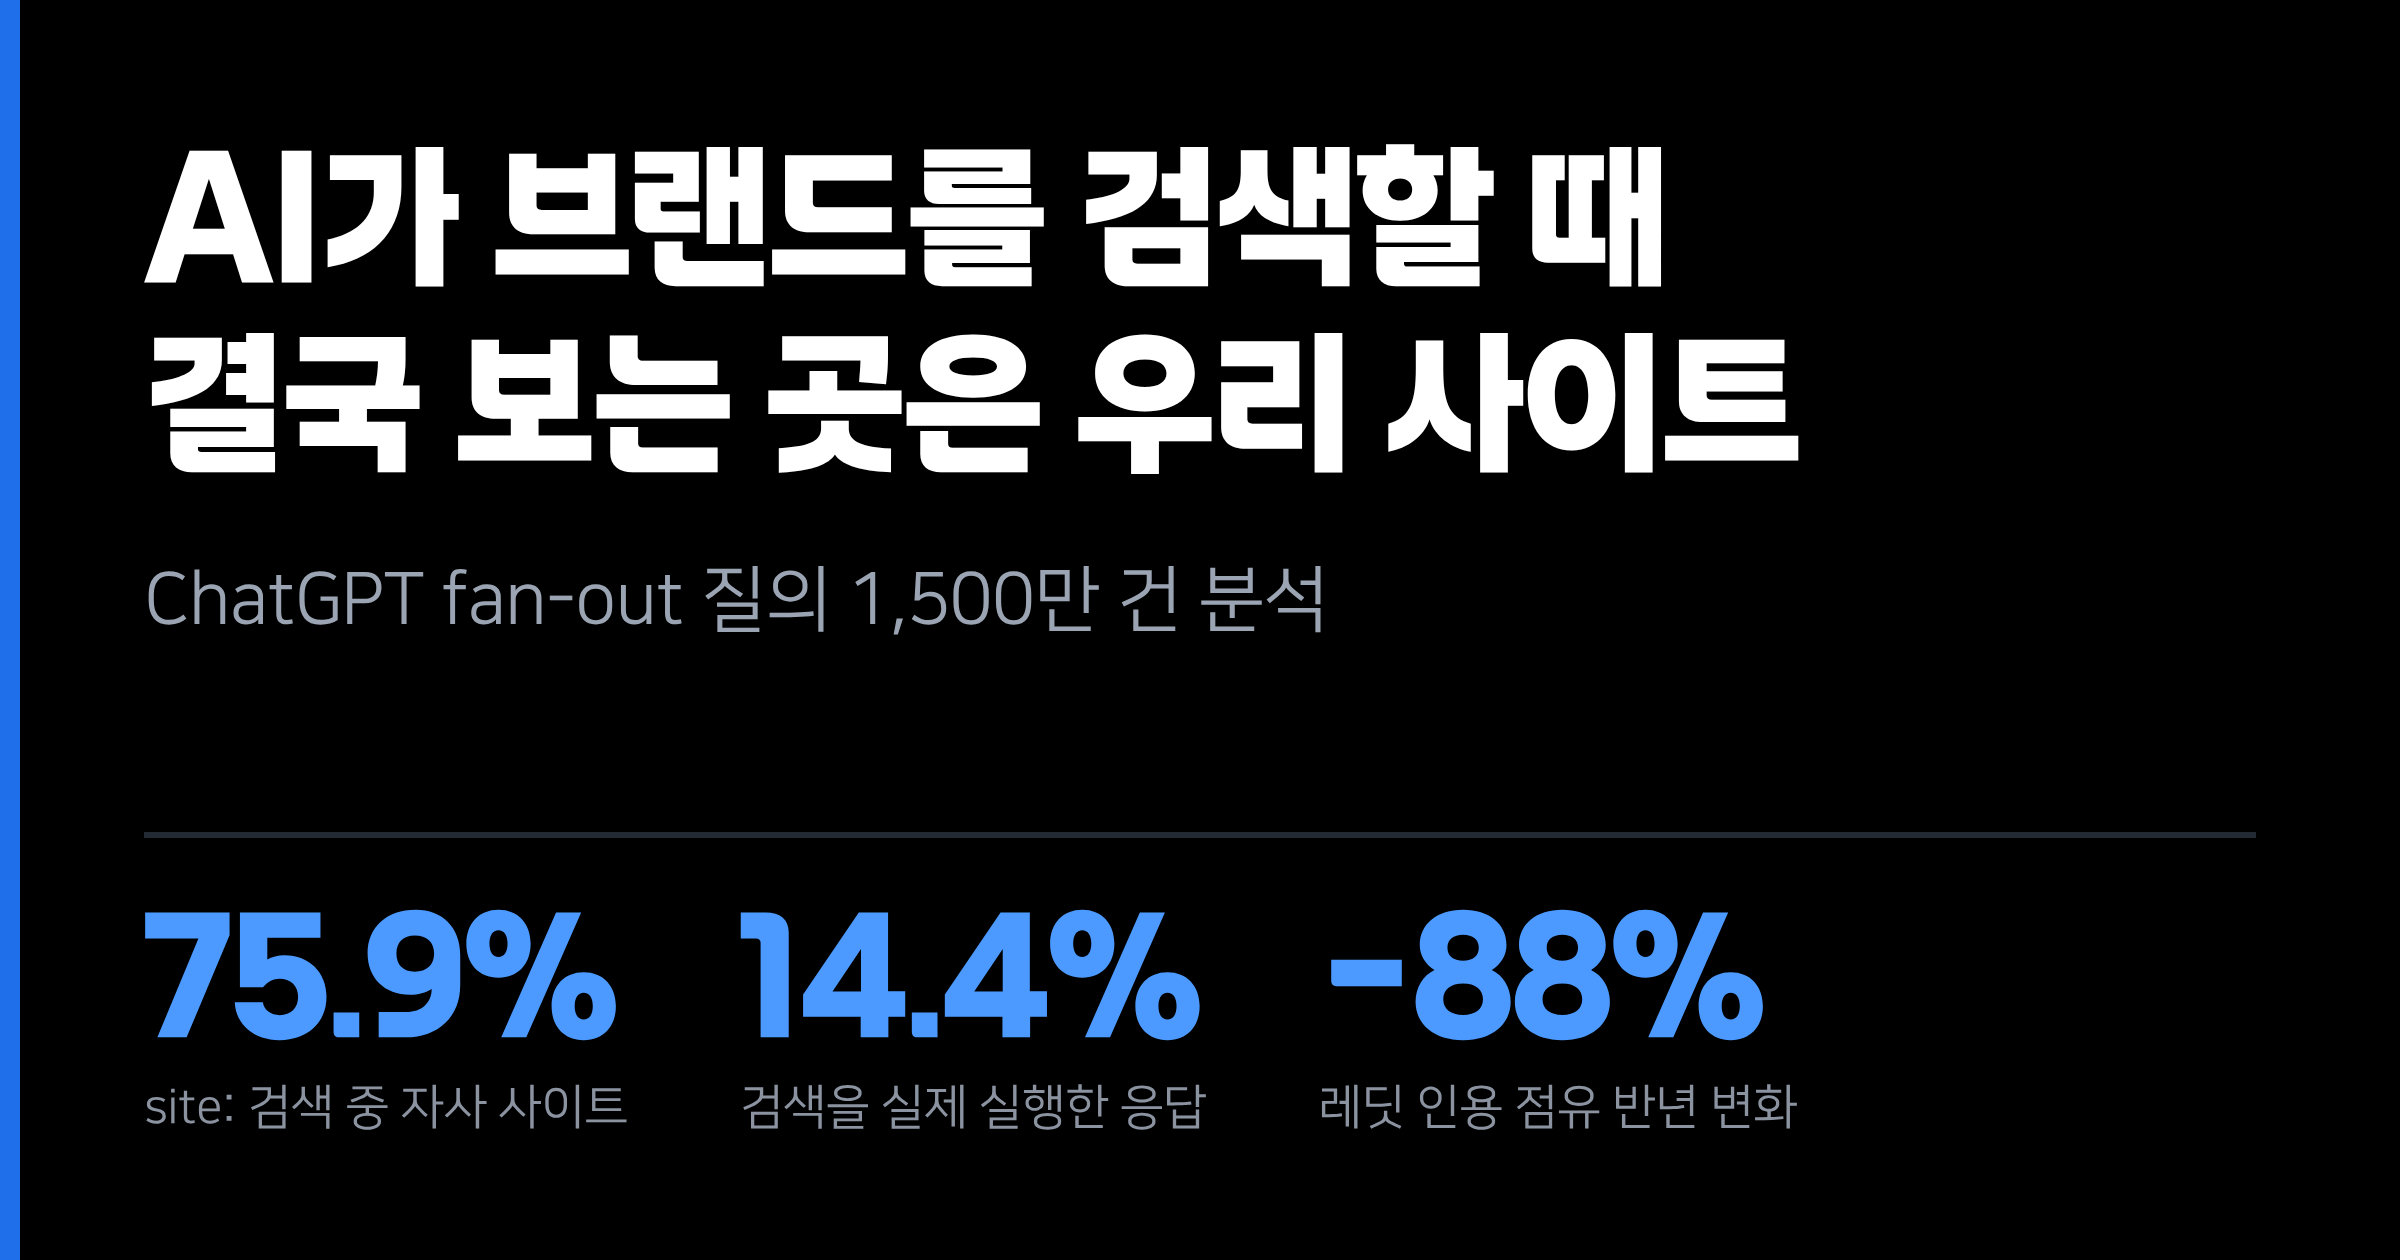
ChatGPT가 답을 만들기 전에 뒤에서 돌리는 검색을 1,500만 건 분석한 자료가 나왔습니다. 결론부터 말하면, 브랜드 관련 질문에서 ChatGPT가 가장 자주 찾아 들어가는 곳은 커뮤니티나 블로그가 아니라 그 브랜드의 공식 사이트였습니다. 특정 사이트를 지정해 검색한 질의 가운데 75.9%가 브랜드 자사 사이트였고, 유통사가 11.9%, 레딧과 페이스북을 합쳐도 1.9%에 그쳤습니다. 지난 반년 사이 레딧 인용은 88%, 위키백과는 80% 줄었습니다. AI 검색 대응의 1순위를 외부 노출에 두고 있었다면, 순서를 바꿔야 할 시점입니다.
<숫자 먼저: 무엇을 측정한 자료인가>
이번 분석의 표본은 2026년 8월과 9월에 수집한 무료·비로그인 상태의 ChatGPT 응답 6,660만 건입니다. 여기서 뽑아낸 fan-out 질의, 즉 모델이 답을 만들기 위해 사용자에게 보여주지 않고 내부적으로 던진 검색어가 약 1,500만 건입니다. 여기에 미국 프롬프트 2만 건 테스트, 그리고 3월부터 9월까지 매달 240만~380만 건의 미국 답변을 추적한 인용 데이터가 함께 붙었습니다.
먼저 눈여겨볼 숫자는 검색이 일어나는 비율입니다. 전체 응답 6,660만 건 가운데 웹 검색을 실제로 실행한 응답은 14.4%였습니다. 일곱 번 물으면 한 번 정도만 밖으로 나간다는 뜻입니다. 나머지는 모델이 이미 학습한 내용으로 답합니다. 그리고 검색을 실행한 응답의 평균 fan-out 질의 수는 1.6개였습니다. 검색 960만 건에서 질의 1,500만 건이 나온 계산입니다.
이 1.6개라는 숫자는 업계에서 돌던 수치와 꽤 차이가 납니다. 같은 주제를 다룬 다른 조사에서는 프롬프트당 7.61개가 나왔고, 질의 두 개 이상이 발생한 프롬프트 비중을 56.5%로 집계한 곳도 있습니다. Thinking 계열 모델에서 15~40개를 관측한 사례도 공유되고 있습니다. 조사를 진행한 쪽도 이 차이를 직접 언급하면서, 자신들의 표본은 폭넓은 일반 질문에 무료·비로그인 세션이라는 점을 단서로 달았습니다. 로그인 상태, 유료 모델, 업무용 질문으로 좁히면 질의 수는 올라갑니다. 숫자 하나만 떼어 쓰면 10배 차이가 나는 영역이라는 점을 먼저 짚어두겠습니다.
<site: 검색의 75.9%가 브랜드 자사 사이트였다>
실무에서 바로 쓸 수 있는 발견은 이 지점입니다. fan-out 질의 1,500만 건 가운데 6.8%는 site: 연산자를 썼습니다. 특정 도메인 안에서만 찾겠다는 뜻이고, 대상 도메인은 약 11만 6천 개로 퍼져 있었습니다.
이 가운데 가장 많이 호출된 약 160개 도메인을 보면 분포가 한쪽으로 쏠립니다.
구분비중브랜드 자사 사이트75.9%유통사 사이트11.9%레딧 + 페이스북1.9%
호출 건수 상위 도메인은 apple.com 9,442건, ikea.com 7,361건, nike.com 5,210건, adidas.com 4,619건, samsung.com 4,432건 순입니다. 레딧은 2,586건으로 9위였습니다. 상위 150위 안에 브라질·영국 정부 도메인, 프랑스 행정 포털, 미국 도로교통안전국, FDA, SEC 같은 기관 사이트가 함께 들어와 있습니다.
읽는 방향은 이렇습니다. 사용자가 "이 제품 사양이 어떻게 되나", "정품 가격이 얼마인가" 같은 질문을 던지면 모델은 그 브랜드 도메인 안으로 들어가 확인합니다. 그 안에 답이 되는 문장이 없으면 모델은 다른 곳에서 주워 온 내용으로 답을 만듭니다. 이때 틀린 사양이나 옛 가격이 섞이는 겁니다.
<질의에 붙는 단어가 '공식'과 '가격'으로 이동하고 있다>
8월과 9월 사이 영문 fan-out 질의에 쓰인 단어 비중도 함께 공개됐습니다.
질의에 포함된 단어8월9월official10.1%13.1%price6.0%8.9%202617.6%22.9%
reviews도 약 3분의 1 늘었습니다. price는 두 달 사이 상대적으로 47% 증가한 셈입니다. 모델이 "공식 정보", "현재 가격", "올해 기준"을 명시적으로 찾아가고 있다는 신호입니다.
이 세 단어는 그대로 홈페이지 점검 항목이 됩니다. 공식이라는 말을 붙여 찾는 질문에 답하려면 회사·브랜드 소개 페이지에 정식 명칭과 사업자 정보, 공식 채널 목록이 텍스트로 있어야 합니다. 가격을 찾는 질문에 답하려면 가격이 이미지나 상담 신청 뒤에 숨어 있지 않아야 합니다. 연도를 붙여 찾는 질문에 답하려면 페이지에 기준 시점이 적혀 있어야 합니다. 이 세 가지가 없는 사이트는 모델이 들어와도 가져갈 문장이 없습니다.
<사실을 묻는 질문의 84.4%는 공식 출처를 인용한다>
미국 프롬프트 2만 건을 대상으로 한 별도 테스트에서는 질문 성격에 따라 인용 구성이 갈렸습니다.
질문 유형공식 출처를 1개 이상 인용한 비율인용 중 공식 사이트 비중사실 확인형84.4%63.4%비교·추천형68.3%46.4%
사양·가격·정책처럼 사실을 묻는 질문에서는 공식 사이트 비중이 60%를 넘습니다. 반대로 "A와 B 중 뭐가 나은가" 같은 비교·추천형에서는 공식 사이트 비중이 46.4%로 내려가고 나머지 절반이 외부 콘텐츠로 채워집니다.
여기서 역할 분담이 나옵니다. 우리 브랜드를 지목한 질문은 자사 사이트가 받아야 하고, 카테고리 전체를 놓고 비교하는 질문은 외부 콘텐츠와 리뷰가 받아야 합니다. 한쪽만 하면 반쪽입니다. 다만 순서는 자사 사이트가 먼저입니다. 브랜드를 지목한 질문에서 틀린 답이 나가면 비교형에서 얻은 노출도 깎입니다.
<반년 사이 인용 구조가 뒤집혔다>
3월부터 9월까지 미국 답변 기준 인용 점유율 변화는 더 큽니다.
도메인3월9월변화레딧19.1%2.3%-88%위키백과14.1%2.9%-80%유튜브——-27%
레딧은 답변 다섯 건당 한 번 인용되던 수준에서 43건당 한 번으로 내려갔습니다. 위키백과는 7건당 한 번에서 35건당 한 번입니다. 둘 다 여전히 상위 인용 도메인에는 남아 있지만 비중 자체가 크게 줄었습니다.
반대로 올라온 쪽은 원 자료를 직접 생산하는 사이트입니다. 의학 논문 데이터베이스 PubMed가 64위에서 4위로 올라왔고 FDA가 8위로 새로 들어왔습니다. 내려간 쪽은 요약·해설 사이트입니다. 건강 정보 매체 WebMD는 18위에서 79위로 밀렸고, 브리태니커·인베스토피디아·뉴욕포스트는 상위 200위 밖으로 나갔습니다.
이 변화가 프롬프트 구성이 바뀐 탓은 아닙니다. 3월과 9월에 공통으로 등장한 약 2만 5천 개 프롬프트만 따로 떼어 본 대조군에서도 같은 방향이 나왔습니다. 모델이 요약물보다 원 자료를 우선해 집어 들고 있다고 보는 게 타당합니다.
참고로 오픈AI와 제휴한 퍼블리셔들의 인용 점유는 3월 7.5%에서 7월 15.8%까지 올랐다가 9월 말 12.5% 수준입니다. 제휴가 인용을 보장하지는 않지만 영향은 있다고 볼 만한 구간입니다.
<그래서 무엇을 먼저 할 것인가>
우선순위를 네 덩어리로 나눠 정리하겠습니다. 뒤 항목은 앞 항목이 끝난 뒤 손대는 게 효율적입니다.
첫째, 자사 도메인에서 사실을 책임지는 페이지를 만드는 일입니다. 제품·서비스 사양, 가격 또는 가격 구간, 이용 조건, 지점·영업시간, 자격·인증 같은 항목이 각각 고정 주소를 가진 페이지에 텍스트로 있어야 합니다. 이미지 안의 숫자, 상담 신청 뒤에 숨은 가격표, 파일로 내려받는 소개서는 모델이 읽지 못합니다. 페이지마다 기준 시점을 한 줄 넣고, 바뀌면 그 줄을 같이 고치는 운영까지 포함됩니다.
둘째, 우리만 만들 수 있는 자료를 쌓는 일입니다. 원 자료를 우선한다는 흐름이 분명하므로, 어디서든 베껴 쓸 수 있는 요약 글은 효용이 떨어집니다. 자사 데이터 기반 집계, 직접 측정하거나 테스트한 결과, 보유 제품 정보처럼 출처가 우리일 수밖에 없는 내용이 남습니다.
셋째, 비교·추천형 질문을 받는 외부 접점입니다. 카테고리를 비교하는 질문에서는 외부 콘텐츠 비중이 절반을 넘으므로, 매체 기고·리뷰·전문가 코멘트 같은 외부 신호가 필요합니다. 다만 여기서도 외부 글이 우리 공식 페이지를 근거로 인용하도록 숫자와 표현을 맞춰두는 게 먼저입니다.
넷째, 측정입니다. 인용 순위는 유입량이 아닙니다. 이번 자료를 만든 쪽도 이 점을 분명히 했습니다. 그래서 두 층으로 나눠 봐야 합니다. 브랜드명과 주요 질문을 정해놓고 월 단위로 직접 물어본 뒤 답변 내용과 인용처를 기록하는 층, 그리고 분석 도구에서 AI 서비스 경유 유입과 그 뒤 행동을 보는 층입니다. 앞쪽이 바뀌었는지 보지 않고 뒤쪽 숫자만 보면 원인을 찾을 수 없습니다.
<정리>
AI 검색 대응을 외부 노출 작업으로 이해하면 비용이 큰 쪽부터 손대게 됩니다. 이번 자료가 보여주는 순서는 반대입니다. 모델은 브랜드 질문을 받으면 그 브랜드 사이트로 들어가고, 거기서 가져갈 문장이 있으면 그걸 씁니다. 공식이라는 단어가 붙은 질의가 10.1%에서 13.1%로 늘고, 가격을 묻는 질의가 6.0%에서 8.9%로 늘어나는 동안 요약 사이트의 인용은 빠졌습니다. 우리 사이트에 사실이 텍스트로 정리돼 있는지, 그 숫자가 지금 기준인지부터 확인하는 게 가장 싸고 효과가 빠른 작업입니다.
이 작업은 한 번 하고 끝나는 종류가 아닙니다. 가격이 바뀌면 페이지가 같이 바뀌어야 하고, 사양이 바뀌면 기준 시점도 같이 바뀌어야 합니다. 지아이오엠이 광고주와 이 작업을 할 때 가장 먼저 만드는 것도 페이지 목록과 담당자, 갱신 주기를 적은 표 한 장입니다. 모델이 읽어갈 사실을 누가 책임지는지 정하는 일이 AI 검색 대응의 출발점입니다.
함께 그려볼까요?